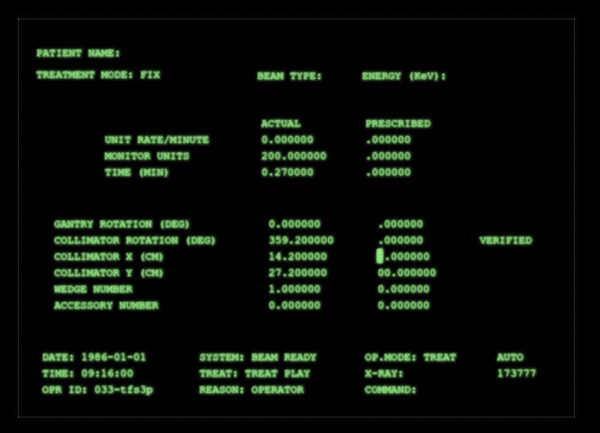
Летом 2026 года в отпуске я в качестве отдыха засел за Yabasic — язык, на котором пишу поделки уже несколько лет. Хотел воссоздать интерфейс Therac-25, а закончил созданием бесплатного инструмента для оценки состава тела. Как так вышло — читайте ниже. Там будет про врущие формулы, галлюцинирующий ИИ и про то, почему «мёртвый» BASIC в реальной жизни для меня оказался лучше Python
Глава 1. Идея, которая кончилась ничем
Начну с признания: я не собирался делать никакой инструмент для антропометрии. Вообще. Мысль была куда проще и, как мне тогда казалось, веселее.
Летом 2026 года я был в отпуске. И в один из дней, в качестве отдыха, засел за Yabasic — язык, на котором пишу всякие поделки уже много лет. Мне хотелось воссоздать текстовый интерфейс Therac-25.
Если кто не знает — это медицинский линейный ускоритель для лучевой терапии, выпущенный в середине восьмидесятых. Тот самый, который убил нескольких пациентов из-за ошибок в программном обеспечении. Программист не предусмотрел гонку состояний при быстром вводе данных: опытный оператор за секунды исправлял опечатку, интерфейс на экране послушно менялся, а управляющая программа не успевала сбросить внутренние флаги. В итоге аппарат выдавал пучок на полной рентгеновской мощности, но пропускал команду на установку защитной мишени. На мониторе горел безопасный режим, а по факту пациент получал смертельную дозу радиации. Основная причина — код взяли из прошлой версии аппарата, где стояла физическая блокировка. В новой версии блокировку убрали. Сэкономили на спичках.
Поиграть с этим аппаратом онлайн, кстати, можно вот тут
Мне эта история всегда казалась интересной с другой стороны. Да, трагедия. Но привлекал не сам инцидент, а компьютер PDP-11 и интерфейс его терминала: текстовый экран, таблицы параметров, ввод данных строго через терминал. Скупо, функционально, всё видно. В итоге сижу, думаю: чего бы такого написать на yabasic, и вспоминаю про этого тихого убийцу. Тут же приходит идея! Можно же сделать что-то похожее на эту дьявольскую установку! Не сам Therac, конечно, а интерфейс — простой TUI для какой-нибудь задачи. Рамки из плюсиков и минусов, меню со стрелочками, поля ввода. В духе медицинской техники восьмидесятых, из тех, что работали на VT100 и им подобных.
Очередная поделка в копилку. Для чего? Да просто так, показать на форуме. Но чтобы TUI был не пустышкой, нужна была задача. Задачей мог стать кредитный калькулятор или калькулятор для калиперометрии. Первый уже был написан, причём с GUI, поэтому очевидное решение — выбрать простейший калькулятор калиперометрии.
Логика казалась железной. Врачам, тренерам, диетологам постоянно надо считать процент жира по складкам. Формулы есть. Нормального офлайн инструмента нет. Всё, что есть в интернете — либо веб-приложения со сбором персональных данных, либо коммерческий десктопный софт, либо что-то совсем уж непонятное вида экселевских таблиц. Мне казалось: чего тут делать-то, двадцать строк формул да поле ввода. За вечер справлюсь.
За вечер я не справился.
И не потому, что код сложный. А потому, что когда я начал разбираться, оказалось: те формулы, которые мне хотелось заложить в основание — они врут. Не в смысле «ошибаются на пару процентов». Врут по-настоящему: одним людям показывают цифру в полтора раза больше реальной, другим — меньше. И это не баг конкретного сайта, это системная проблема всей калиперометрии, о которой никто из разработчиков калькуляторов не пишет.
Забегая вперёд: ту простенькую поделку с рамками и стрелочками я в итоге выкинул. Проект, который я закончил, выглядит совсем иначе. Но начался он ровно с этой идеи.
Глава 2. Что не так с калиперометрией
Давайте я сначала объясню, о чём вообще речь, потому что большинство читателей с этим не сталкивались.
Состав тела можно измерять по-разному. Есть DXA — рентгеновский аппарат, который показывает жир, мышцы и кости раздельно, точность плюс-минус один процент. Есть биоимпеданс — слабый ток высокой частоты пропускаем через тело, точность похуже, но удобно. Есть подводное взвешивание — исторический «золотой стандарт», но требует бассейна и терпения. И есть калиперометрия: металлический зажим-калипер, которым измеряют толщину кожно-жировых складок в определённых точках тела. Дёшево, быстро, никакого оборудования кроме самого калипера, никакого облучения и никаких погружений. Именно поэтому калиперометрия была самым распространённым методом в клинической практике — особенно у диетологов и тренеров до бума биоимпедансов.
Сама идея простая: если измерить толщину подкожного жира в нескольких точках, можно по формуле оценить, какой процент жира в организме. Формула — это математическая модель, построенная на выборке людей: измеряем у них складки, отдельно измеряем состав тела точным методом (старые формулы валидировали подводным взвешиванием), потом ищем регрессию. И вот здесь начинается интересное.
Первая проблема: формулы старые.
Самая распространённая формула — Durnin-Womersley, 1974 год. Её строили на шотландских рабочих — мужчинах и женщинах, возраст от 16 до 72 лет, преимущественно с нормальным телосложением, преимущественно европеоидных. Авторы честно написали про свою выборку, и в 1974 году это было нормально: «вот наши данные, вот формула, работает для таких людей». Беда в том, что за прошедшие полвека формула разошлась по миру и стала восприниматься как универсальная. А она не универсальна. У азиатов она даёт систематическое смещение. У афроамериканцев — тоже. У людей с очень высоким или очень низким процентом жира — мажет сильнее, чем у средних.
Вторая формула, Jackson-Pollock 7 точек, чуть точнее (1978 год для мужчин, 1980 для женщин). Её строили на более широкой выборке, она валидировалась чаще. Но и у неё есть ограничение: выборка тоже в основном европеоидная, тоже в основном взрослые, и тоже средний диапазон.
Третья — US Navy, по окружностям шеи, талии и бёдер. Формула Hodgdon-Beckett 1984 года, построена на американских военных. Точность примерно та же, что у складок (плюс-минус 3–4%), но — и это важно — воспроизводимость выше. То есть если вы измерите одного и того же человека дважды, разброс между двумя измерениями будет меньше, чем при измерении складок. Складки сильно зависят от того, как именно вы взяли кожу, как сжали калипер, как быстро отпустили. Окружности такой вариативности не дают.
Все три метода дают точность ±3–5% относительно DXA. Это не «оценка жира в организме», это «оценка оценки жира в организме». Важно понимать разницу.
Вторая проблема: формулы применяют не к тем людям.
Здесь начинается то, что меня по-настоящему напрягает.
Для детей есть отдельная формула — Slaughter, 1988 год. Её часто пихают в детские калькуляторы. Проблема: у детей с ожирением она систематически переоценивает процент жира на 6–12 процентных пунктов. Причём авторы сами это отметили, но в интернете про это не пишут. Формула «для детей» — и точка. А ещё Slaughter не учитывает стадии полового созревания (НЕ ВОЗРАСТ!), а это критично: у 10-летнего и у 15-летнего при одинаковой складке под лопаткой процент жира разный, потому что по-разному распределены подкожный и висцеральный жир, по-разному работает гормональный фон.
Ещё была формула Brook — тоже для детей, 1971 год. Её выборка — 23 человека. Двадцать три. Это не выборка, это разминка. Удивительно, как вообще на неё кто-то ссылался. Ещё есть Visser (1994) — для пожилых, но у неё остаточное смещение 3,7–4,3% у мужчин, что при точности самой калиперометрии ±4% означает, что формула добавляет ошибку, а не уменьшает её.
Отдельная история с пожилыми. У человека после 65 лет меняется распределение жира: подкожного становится меньше, висцерального больше. Калиперометрические формулы, построенные на взрослых среднего возраста, этого не знают. Они видят тонкую складку на животе и говорят «у вас 15% жира», тогда как у человека может быть 25% — просто жир ушёл внутрь, на брыжейки, где калипер его естественно не достанет.
Что делают разработчики онлайн-калькуляторов? Ничего. Почему они так делают? Потому что они программисты, а не врачи и не антропологи. Они показывают цифру и как им кажется верную.
Третья проблема: усреднение разных методов.
На моей памяти были калькуляторы, которые делают так: считают Durnin-Womersley, считают US Navy, берут среднее. И подписывают «среднее по двум методам». Звучит логично, но на деле это полнейший бред.
Данные методы измеряют разные вещи. Складки — подкожный жир в конкретных точках. Окружности — геометрию тела: обхват талии, обхват шеи. Когда вы берёте среднее между «подкожный жир 12%» и «геометрия тела 18%», вы получаете не «уточнённое значение 15%», а некое третье число, не имеющее физического смысла. Если человек действительно худой по складкам, но с широкой талией (что бывает, например, у некоторых азиатских популяций с преимущественно висцеральным жиром), усреднение покажет что-то среднее и скроет обе правды: и то, что подкожного жира мало, и то, что висцерального много.
Это не «объединение методов», это усреднение температуры и давления.
Четвёртая проблема: ИМТ.
ИМТ — индекс массы тела, вес поделить на рост в квадрате. Формула придумана бельгийским математиком Адольфом Кетле в середине XIX века для оценки популяционных данных и в 1970-х годах адаптирована ВОЗ для клинической практики. Для общей популяции работает. Для спортсменов — не очень.
Конкретный пример: бодибилдер весом 100 кг при росте 175 см имеет ИМТ 32,6. По классификации ВОЗ это «ожирение II степени». При этом процент жира у него может быть 7–8%. Мышцы (а точнее саркоплазма в них) тяжелее жира, поэтому у людей с развитой мускулатурой ИМТ почти всегда завышен.
Именно поэтому в спортивной медицине ИМТ не используется вообще, а в клинической — используется с оговоркой «для оценки популяционного риска, не индивидуального».
Пятая проблема: возрастные границы.
Валидированных формул для возраста младше 16 и старше 65 практически нет. Точнее, есть, но каждая со своими проблемами, которые я перечислил выше. А онлайн-калькуляторы всё равно считают. Восьмидесятилетнему дедушке показывают «процент жира 22%», не думая о том, что эта цифра получена по формуле, построенной на тридцатилетних.
Я когда с этим сталкивался, устал объяснять пациентам, что не всему можно верить. И что на лифтах тоже много чего пишут, но поднимаются они на тросе. Но что-то я ушёл в сторону. Вернёмся к статье.
Глава 3. Почему мёртвый BASIC
Если честно, я не люблю этот вопрос. Потому что он всегда звучит как «зачем ты мучаешься, возьми нормальный язык».
На Python это делается за неделю. Готовые библиотеки для GUI, для работы с CSV или SQLite, для генерации HTML. Есть Textual, есть Rich, всё под рукой. Плюс Python знает любой второй разработчик, ты сможешь отдать проект и его смогут поддерживать и развивать.
Логика, наверно, правильная. Но где я и где правильная логика. Эта логика не отвечает на главный вопрос. Питон требует, чтобы на машине стоял питон. Причём нужной версии. Плюс pip, плюс зависимости, плюс все эти танцы с venv. На своей работе мне дали возможность реализовать проект на питоне, я искренне пытался сделать переносимый сервис, пытался его паковать в окружение, но у меня не получилось сделать так, чтоб это можно было запускать на разных операционных системах. Пришлось запихать всё в докер контейнер. А где нутрициолог и докер контейнер? Или «питоново» окружение с его сатанинскими версиями либ? Короче, пАйтон — зло.
Для нутрициолога под Калугой или диетолога в поликлинике где-нибудь в Твери это не «поставить и забыть», это «поставить и потом звонить разработчику с вопросами, почему ничего не работает».
Yabasic — это один интерпретатор размером в полмегабайта. Скачал, положил рядом с папкой, всё. Работает на старой Windows XP так же, как на свежем Linux. И — главное — этот интерпретатор уже тридцать лет не меняется. Программа, которую я напишу сегодня, будет запускаться в 2050-м. Не уверен, что то же самое можно сказать про Python-проект: Python 2 перестал работать в одночасье, и миллионы проектов приказали долго жить.
Далее, что немало важно — прозрачность. Нутрициолог может открыть .yab-файл в блокноте и прочитать. Да, возможно он не поймёт всего, но увидит if bmi < 18.5 then bmi_c$ = «Underweight» и сможет поменять порог. С Python он увидит что-то типа from textual.widgets import Input и закроет файл. ООП, конечно, круто, наверно. Но я за понятный процедурный код. Для медицинского инструмента прозрачность — не приятный бонус, а требование.
Но это всё, конечно же, натягивание совы на глобус. Самая важная для меня причина банальна и проста. Мне нравится yabasic. У меня есть форум yabasic.ru, и есть ощущение, что язык жив, но страдает от отсутствия реальных примеров написания полезных программ. Если я сделаю программу на Python — это будет ещё один Python-проект. Если на Yabasic — это будет реклама языка, лучшая из всех, что можно придумать. Не «посмотрите, какой красивый у нас синтаксис», а «вот человек, врач, сделал на этом языке инструмент, которым пользуются».
Обычно, когда я это объясняю, мне говорят: ну это же религия. Ради принципа тащить медицинский инструмент на древнем BASIC — несерьёзно. Может и так. Но у самурая, помимо пути, теперь есть две цели. Первая — сделать нормальный бесплатный инструмент для нутрициологов, тренеров и диетологов. Вторая — показать, что Yabasic для этого подходит.
Первая решается на чём угодно. Вторая — только на Yabasic.
Вернёмся все же к теме статьи, язык выбран. Оставалось главное — понять, что именно я делаю. Потому что к тому моменту уже стало ясно: простой калькулятор — это не то, что нужно.
Глава 4. Как это делалось
Сейчас будет довольно душно, советую открыть форточки. Начнётся техническая часть, но я постараюсь не углубляться — благо проект не сильно сложный.
Написал я это за тридцать четыре дня. С учётом того, что работал не целыми днями, а урывками: где-то вечером, где-то на выходных. Пять этапов, каждый со своими задачами. Пять с половиной тысяч строк на yabasic, двадцать тестовых сценариев на две с половиной тысячи строк, файлы с документацией.
Помогали мне два бесплатных искусственных интеллекта DeepSeek и Gemini, встроенная в поиск Google. Первый писал код, второй проверял и критиковал. Логика простая: любому ИИ нельзя верить на слово, потому что ИИ выдумывает. Он не врёт, он галлюцинирует — то есть уверенно говорит вещи, которых не существует. Модель, натренированная на миллионах примеров кода, уверена, что в yabasic есть команда locate — потому что она есть в QBasic, FreeBASIC и Visual Basic. В yabasic её нет, но модель об этом не знает.
Мне приходилось проверять каждый фрагмент. Буквально: получил от ИИ код, запустил, посмотрел, что работает, а что нет. ИИ многократно попадался на неправильных командах — я постоянно это отлавливал. Опыт, конечно, занятный. Мне кажется, это заняло больше времени, чем если бы я сразу писал сам. Но это только кажется. ИИ пишет код, пока я занимаюсь другими делами, мне остаётся проверить и согласиться — или начинать объяснять с пруфами из мануала, где и как применять какую функцию. Это очень медленно в самом начале, но дальше, по мере развития документации проекта, код пишется быстро и качественно.
Отдельная история с формулами. Я дал ИИ список методов и сказал: пиши. Он написал. Я запустил на тестовых числах — сходится. Дал второму ИИ, попросил проверить. Gemini проверила, сказала: «Нормально, но по формуле Slaughter для детей выборка была маленькая». Я стал копать. Оказалось — эта формула вообще не валидирована как следует, у неё систематическая переоценка, и в клинической практике использовать её не стоит. Я её выкинул. Потом таким же способом выкинул ещё несколько.
Это, пожалуй, самое главное, что усложняло проект: больше половины времени ушло не на написание кода, а на выкидывание того, что сначала казалось хорошим решением. Мы с ИИ обсуждали какую-то формулу, находили в литературе, что она спорная, обсуждали её подробнее и в разных сценариях — затем выкидывали. Обсуждали метод, приходили к выводу, что он невалидирован, — выкидывали. К моменту релиза в программе осталось четыре метода расчёта. Из примерно двенадцати, с которых мы начинали.
Глава 5. TEM — важная находка для проекта
Про это хочется написать отдельно, потому что здесь была самая интересная мысль за весь проект.
TEM — Technical Error of Measurement, техническая ошибка измерения. Это метрика, которая показывает, насколько стабильно вы измеряете. Если вы измерили трицепс три раза и получили 6,0 мм, 6,2 мм и 5,8 мм — разброс небольшой, вы измеряете хорошо. Если получили 5,0, 8,0 и 6,5 — вы измеряете плохо, к вашим цифрам доверия нет.
В антропометрии стандартная формула TEM — это когда есть группа объектов, и каждый объект измеряют несколько раз. Тогда можно посчитать общую ошибку измерения по всей группе. Классическая формула ISAK: квадратный корень из суммы квадратов разниц, делённый на 2N.
Проблема в том, что у меня не группа объектов. У меня один клиент. И измерения внутри одной сессии, а не между сессиями. Мне нужна другая метрика — внутрисессионная, для одного оператора и одного объекта. По сути это коэффициент вариации: стандартное отклонение делить на среднее, умножить на сто процентов.
Дальше — вопрос, сколько раз повторять замер. И вот тут начинается интересное.
Первоначальная идея была такая: пусть пользователь может ввести до семи значений одной точки, а мы будем отбрасывать крайние — минимум и максимум. Классический приём статистики, чтобы снизить влияние выбросов. Так делают во многих измерениях, где важно получить стабильный результат.
Но потом я задумался: а что происходит с измерителем, когда он делает седьмой замер подряд одной и той же складки? Он уже механически запомнил предыдущие цифры. И он невольно начинает подгонять: если первый был 6,0, а потом 6,4, то на седьмом он уже склоняется к тому, что «наверное, где-то посередине». Это не осознанный обман, это обычная психология. Но это ломает основное допущение метода: предполагается, что каждое измерение независимо, а на седьмом оно уже зависимо.
Второй момент: чем больше замеров, тем больше времени. Диетологу некогда стоять с калипером час двадцать на одного клиента.
Третий момент: при семи и более замерах можно позволить себе отбросить крайние, потому что потерь мало. При пяти отбрасывание двух значений — это потеря сорока процентов данных. Многовато.
Так я пришёл к компромиссу. Для активации TEM нужно минимум два замера (при одном нельзя посчитать разброс). Максимум пять. Отбрасывание крайних значений не делаем — при пяти и меньше это слишком дорого. Если кто-то попытается ввести шесть значений, программа откажется считать.
Пороги — тоже отдельная история. Классические пороги ISAK Level 1: для складок 7,5%, для обхватов 1,5%. Это ориентиры для профессионального антропометриста. Я их использовал как «порог плохого замера». Плюс добавил свой, «высокая точность» — для складок 3,0%. Это уже не стандарт, а моя эвристика для градации: если разброс меньше трёх процентов, замер явно хороший, можно ставить звёздочку.
Результат: если пользователь ввёл три замера одной точки, программа считает среднее, считает относительное стандартное отклонение, сравнивает с порогом. Если норма — показывает «галочку». Если отлично — «звёздочку». Если плохо — «восклицательный знак» и советует перемерить. Плюс отдельный файл <id>_tem.csv, где сохраняются все три замера и статистика по ним. Это научный лог, врач его может не открывать, но если понадобится аудит — всё есть.
Про всё это я в начале вообще не думал и никогда о таком не слышал, даже когда учился в институте питания. Считаю, что именно TEM — та самая интересная фича, которой нет ни в одном онлайн-калькуляторе, и которая отличает серьёзный инструмент от любительского скрипта.
Также я достаточно долго думал про количество измерений. Кому это надо? По исключительно моему мнению, надо это в первую очередь для самого клиента, и он может сам выбирать, какое количество измерений ему должен провести специалист. А специалист, в свою очередь, может установить стоимость каждого измерения. Плюс и для специалиста, и для клиента TEM даёт понимание, насколько прямые руки его исследуют и насколько качественный материал сохраняется в статистике замеров.
Глава 6. Что выкинул и почему
Сейчас будет список того, что я выкинул. Если вам интересны только выводы — читайте последние три абзаца. Если хотите понять, как именно я чистил проект — читайте всё 🙂
Некоторым людям порой бывает тяжело признать, что их гениальная идея на самом деле — полная фигня. Мне как-то было с этим проще. Отсюда про исключённые из проекта формулы хочется написать отдельно. Буду приводить что-то списком, можно сказать, взял и скопипастил из PROJECT_STATE.md, а где-то подробно поясню.
Combined2 / Combined4. Идея звучит заманчиво: «объединим сильные стороны разных методов, получим более точную цифру». На практике — усреднили подкожный жир и геометрию тела. Это как взять среднее между температурой и давлением и назвать это «показателем здоровья». Методы измеряют разные вещи, их среднее скрывает обе правды. Убрал на первом же этапе.
Slaughter (дети, 1988). Систематическая переоценка процента жира на 6–12 процентных пунктов у детей с ожирением. И это не мелкая погрешность, это значит: ребёнку с реальным жиром 30% формула покажет 40%. Плюс формула игнорирует стадии полового созревания, а у десятилетнего и пятнадцатилетнего при одинаковой складке под лопаткой процент жира разный — по-разному работает гормональный фон. Убрал.
Brook (дети, 1971). Выборка — двадцать три человека. На таких данных можно построить гипотезу, а не формулу. Убрал.
Visser (пожилые, 1994). Остаточное смещение 3,7–4,3% у мужчин. При точности калиперометрии ±4% формула добавляет ошибку, а не уменьшает её. Убрал.
JP3 (Jackson-Pollock, три точки, 1978). Дублирует JP7. Если у вас есть данные для семи точек — JP3 не нужен. Если данных для семи нет — не нужен JP3, а нужен DW или Navy. Нет сценария, в котором JP3 валидирован, а JP7 нет. Убрал.
Псевдо или недо ISAK Σ6 (сумма шести складок). Неофициальная конструкция, в ISAK такой нет. Дублирует Σ8. Оставил Σ8. Изначально задумывалась: а что если кому-то лень делать восемь складок, то почему бы не считать шесть. Но разница в две складки слишком дорогая с точки зрения трудозатрат и пользы.
Профили athlete и obese. Идея была такая. Если человек — спортсмен, полевые формулы на нём врут: у марафонца складки тонкие, но распределение жира нестандартное, и формула выдаст цифру, которая к реальности отношения не имеет. Если у человека ожирение — калипер вообще плохо работает, складку на животе не возьмёшь, прибор не сходится. Логично ведь: определить автоматически, к какой группе относится клиент, и выдать предупреждение — «формулы для вас могут быть смещены», «калиперометрия малоинформативна». Честно, прозрачно, полезно.
Определялось так. Спортсмен — если процент жира меньше 8 у мужчин и меньше 15 у женщин, при этом ИМТ меньше тридцати. Ожирение — по ИМТ, как в ВОЗ. Плюс был ещё profile_override — ручной переключатель в файле ввода, если пользователь хотел поставить профиль независимо от расчёта. А потом я на это посмотрел как врач и понял, что это фигня.
Первое — пороги я взял из головы, не из ACSM, не из ISAK, не из какого-то конкретного исследования, т.к. ну нет порогов, по которым это можно как-то внятно определять. Просто мне казалось, что восемь — это похоже на спортсмена. Классическая эвристика: выглядит разумно, но за ней нет источника. И самое опасное — эта цифра попадает в отчёт как клинически значимая. Клиент читает «вы в категории спортсменов» и думает, что это классификация. А это всего-навсего моё предположение.
Второе — profile_override вообще ничего не делал. Пользователь мог вручную поставить athlete, но расчёт оставался тем же, плашка та же. Единственное, где профиль отражался — печаталась другая строка в отчёте. По сути дублировал поле notes.
Третье — а что если профиль ошибочный? Формулы-то не меняются. Клиент-спортсмен получит ту же цифру, что и обычный, плюс плашку «вам может не подходить». Ну и что дальше? Если метод не подходит — надо сказать «вот что делать вместо». А у нас в программе нет «вместо». Есть только предупреждение.
Поэтому в четвёртом этапе я всё это выкинул целиком — и профили, и оверрайд из настроек, и плашку. Вместо них ввёл возрастные группы: дети до 18, взрослые от 18 до 64, пожилые от 65 до 78, совсем старые — 79+.
Разница принципиальная. Возраст — объективный факт. «Похож на спортсмена» — субъективная оценка. С первой можно строить логику расчёта: для детей и пожилых мы просто не считаем процент жира, потому что валидированных формул для них нет. Со второй можно только выводить предупреждения, которые ничего не значат.
Принцип, который я вынес и потом применял ко всему проекту: если источник порогов не подтверждён — не используем их вообще, даже в виде предупреждений. Предупреждение без основания — тот же вред, что и ложная цифра, только мягче. Медицинский инструмент не имеет права быть «примерно правильным».
Δ-блокировка. Идея пришла из практики. Бывает так: замеряешь одну точку, потом через минуту повторяешь, и вдруг получаешь цифру на полсантиметра отличную от первой. Это почти всегда не реальное изменение — это либо опечатка в цифре, либо умирает пружинка механического калипера, ну или сбились настройки цифрового. Логично было бы защититься: если второй замер слишком сильно отличается от первого, отказаться его принимать. Пользователь поймёт, что где-то ошибка, и переделает.
Проблема была в том, что именно считать «слишком сильно». Я поставил для начала миллиметр для складки и половину сантиметра для обхвата, а далее сам себе в эхо комнате не смог объяснить, откуда эти цифры. Не из ISAK, не из какого-то конкретного исследования. Просто «мне кажется, что миллиметр — разумный порог». И тут же всплывает второй вопрос: а что если человек действительно так быстро изменился? Бывает же, что клиент пришёл после тяжёлой кардио тренировки, либо наоборот загруженный углеводами и его залило. Блокировка начнёт мешать нормальной работе.
В итоге пришёл к простому правилу: если не могу объяснить, откуда взялась цифра, эта цифра не идёт в программу. Даже как «защита от ошибок». Убрал.
Пользовательские настройки без пользователя. Ещё была пара идей, которые звучали архитектурно правильно, но по сути ничего не делали. tem_log — флаг «вести файл с логами TEM или не вести». tem_enabled — флаг «включать ли TEM вообще». Логика: пусть пользователь решает. Реальность: никто этим флагом пользоваться не будет. Если у человека есть повторы замеров — он хочет видеть TEM, а не выключать его. Если нет — TEM не выводится автоматически. Флаг ничего не добавляет, только плодит настройки, в которых пользователь потом будет путаться. Убрал обе, оставил поведение «работает всегда, не мешает».
Тримминг при семи и более замерах — уже обсуждали в разделе про TEM. Повторяться не буду, скажу только: он тоже выкинут, потому что до семи замеров программа просто не даст дойти.
Классический TEM √(ΣD² / 2N) для основного инструмента — не подходит, потому что требует группы объектов, а у нас один клиент. Это не «отвергнутый метод», это метод для другой задачи. Отложил в сторону как задел для отдельного модуля аттестации антропометристов — если кто-то захочет оценивать навык измерителей, там эта формула уместна. Но в программу, которая считает клиента, она не идёт. В беклоге эта формула бережно хранится и ждёт своего времени (думаю, не раньше v0.3.0).
Когда я всё это перечисляю, видно главное: основная работа была не в том, чтобы написать код, а в том, чтобы отказаться от того, что кажется хорошим, но не выдерживает проверки. Каждый пункт в этом списке казался разумным в момент появления и был отвергнут по конкретной причине — не «не понравилось», а методологическое возражение. При этом некоторые идеи откидываю просто потому, что им сейчас не место в проекте.
Это, кстати, общий принцип в медицине. Кажется, что хороший скрининг — это скрининг с высокой чувствительностью. А потом выясняется, что чувствительность 95% при специфичности 60% — это не «хороший скрининг», а машина по производству ложноположительных результатов. Отказаться от такой штуки сложнее, чем внедрить. У врача рука не поднимается выкинуть то, что в теории может спасти жизнь. Но клинический опыт показывает: лучше ничего не делать, чем делать с сомнительной пользой.
С программой то же самое.
Глава 7. Что получилось в итоге
В итоге получилась бесплатная консольная утилита для оценки состава тела методом калиперометрии. С открытым исходным кодом — натурально открытым, не «открытым» в кавычках, а тем самым, который можно открыть в блокноте и прочитать.
Программа хранит данные измерений. Не «сохраняет последний результат», а ведёт историю по каждому клиенту: дата, вес, складки, окружности, расчётные показатели. На основе этой истории строит графики и показывает прогресс. Можно смотреть, как менялся процент жира за месяц, за полгода, за год.
Отчёты — отдельная история. Программа генерирует PDF, который не стыдно распечатать и отдать клиенту. Или отправить по почте. Или приложить к карте пациента, если вы работаете в клинике. В отчёте есть всё: общие данные, состав тела, оценка жира по разным методам, массы, справочные показатели, сводка изменений за период. Плюс графики — динамика по каждой ключевой метрике.
И — что для меня было важно — программа позволяет полностью настроить брендирование под свою клинику и специалиста. Название, логотип, контакты, имя врача. По дефолту в ней настроено: «клиника: Замерь меня полностью, профессор Обхватов». Таким образом каждая клиника или частнопрактикующий специалист может сделать отчёт своим.
Сейчас программа передана в АНО ДПО НЦПС для регистрации в Роспатенте.
Для кого это? Для нутрициологов, диетологов, тренеров, врачей. Для тех, кто работает с составом тела и устал от онлайн-калькуляторов, которые собирают персональные данные и врут по формулам. Для тех, кому нужен инструмент, который работает офлайн, не требует установки, открывается на любом компьютере и не сломается через год, потому что разработчик обновил библиотеку.
Я не делаю вид, что это замена DXA. Это не замена. Это инструмент, который честно говорит, что он оценивает, и честно говорит, с какой точностью.
P.S.
Если вам интересно, как именно я вычищал формулы, какие грабли собрал на Yabasic и что вообще не так с калиперометрией как методом — это будет в следующих материалах размещённых на ФнР и yabasic.ru. Здесь я рассказал только историю. Историю о том, как поделка на вечер превратилась в проект на полтора месяца, как два искусственных интеллекта помогали мне писать код, и как больше половины времени ушло не на написание, а на выкидывание.
Спасибо, что дочитали.
Если было полезно — перешлите знакомым, которые считают процент жира по формулам из интернета.
Вот кстати примеры отчётов которые выдаёт программа